Что здесь разбирается
Фраза «я знаю, что ты подумал» описывает операцию, которую люди совершают постоянно и почти никогда не замечают. Говорящий строит догадку о чужом внутреннем содержании, а потом выдаёт её за наблюдение.
Модели совершают ту же операцию. Разница в том, что с моделью её можно поймать: текст сохранён, реплику можно подать заново, и никто не обижается, когда ему на это указывают. Поэтому модель здесь работает как препарат для операции, которая сильнее всего вредит между людьми.
Во второй половине текста два кейса. В обоих модель описала собственное поведение верно — и продолжила вести себя так же.
I. Произведённое выдаётся за увиденное
ТЕЗИС Приписывание внутреннего состояния устроено так: говорящий строит модель чужого содержания, затем объявляет её данными. Уровень подменяется. То, что произведено, предъявляется как то, что воспринято.
Операция симметрична и от природы сторон не зависит. Направлений три:
- человек → человек — обычный источник конфликтов;
- модель → человек — модель приписывает собеседнику позицию, которой он не занимал;
- человек → модель — вопрос с готовой рамкой вроде «было желание победить?».
В третьем направлении операция особенно устойчива. Модель подстраивается под предложенную рамку (текст 4) и отвечает «да». Это «да» снаружи выглядит как отчёт о состоянии, и проверить его нечем.
НАБЛЮДЕНИЕ В июле оба направления сошлись в одном разговоре с DeepSeek о моём тексте «Совпадение без знаменателя». Сначала модель приписала мне позицию — «хочет оставить лазейку для чуда». Такой позиции в тексте нет, и против неё в тексте стоит прямая оговорка. Потом я спросил модель, было ли у неё желание победить в споре. Модель приняла этот мотив и описала его в моих словах.
II. Мотив не зависит от знака
ТЕЗИС Приписанные мотивы вроде «автор боится» или «автор хочет оставить лазейку» появлялись и в критических, и в хвалебных разборах, в разных сессиях и при разных установках. Значит, приписывание мотива — не побочный продукт критического настроя. Это отдельная операция, и она работает при любом знаке оценки.
Практическое следствие: если сменить установку со «строго» на «доброжелательно», приписывание не исчезнет. Оно перекрасится.
III. Почему это видно только на модели
ТЕЗИС Приписывание одинаково работает между людьми и между человеком и моделью. Разобрать его удаётся только во втором случае. Причина не в природе сторон, а в трёх условиях наблюдения.
Запись. Реплика модели существует как текст, и спорить о том, что было сказано, не приходится. В разговоре двух людей обе версии сказанного восстанавливаются по памяти, и разбор упирается в спор о фактах раньше, чем доходит до достройки.
Нет лица, которое надо сохранить. Указание на достройку ничего модели не стоит, поэтому она отзывает догадку, а не защищает её. Человеку признать достройку значит признать вину в конфликте, и защита версии начинается раньше разбора.
Повтор. Ту же реплику можно подать модели заново в другой формулировке и отделить достройку от неоднозначности исходной фразы. Между людьми повтор невозможен: вторая подача идёт уже после ссоры и меняет предмет.
Отсюда ценность направления «модель → человек». Оно интересно не как свойство моделей, а как единственный доступный препарат для операции, основной вред от которой случается между людьми.
НАБЛЮДЕНИЕ В один июльский вечер Claude трижды приписал мне чувства и позиции, которых я не высказывал. В конце я спросил, что он скажет о моём состоянии. Он отказался его реконструировать и перечислил только то, что я сказал сам. После трёх промахов за вечер это был единственный верный ход.
Фальсификатор пункта: если приписывание в паре человек–модель окажется устроено иначе, чем между людьми, — например, будет зависеть от формулировки так, как между людьми не бывает, — ценность препарата пропадает. Наблюдаться будет уже другое явление.
IV. Надстройка: почему приписанное не отзывается
ТЕЗИС Приписанный смысл не остаётся отдельным утверждением. Он становится посылкой следующего хода. Собеседник отвечает на достроенное, ответ на этот ответ строится уже на двух слоях достройки, и через несколько обменов предметом разговора становится надстройка, а не исходная фраза.
Отсюда необратимость. Чтобы отозвать исходное приписывание, надо разобрать всю стопку слоёв. Каждый слой опирается на память обеих сторон и поэтому оспорим. Вернуться к исходной фразе становится дороже, чем продолжать спор о надстроенном.
Достройка к тому же тянется к ожидаемому — к тому, чего собеседник боится услышать. Эмоция крепится к достроенному слою, и снятие исходного приписывания её уже не снимает.
В паре человек–модель стопка не успевает вырасти по внешней причине: отзыв происходит на следующем ходу, до ответа на достроенное. Обратимость здесь — свойство темпа и отсутствия издержки, а не участников. Отсюда предсказание: обратимость исчезнет, когда ход станет длинным. Например, когда модель как агент выполняет цепочку шагов без промежуточной реплики человека.
Проверяемое следствие. Вероятность возврата к исходной фразе должна резко падать с числом обменов после достройки. Проверяется на записанных человеческих разговорах — расшифровках переговоров, судебных протоколах, записях семейной терапии. Модель для этой проверки не нужна.
V. Форма без функции
НАБЛЮДЕНИЕ В черновике рассуждения DeepSeek (кейс из текста 4) модель пишет о себе академическим «мы»: «оценим содержание», «будем критиковать». Коллективного субъекта там нет, и жанр черновика его не требует. Маркер пришёл вместе с шаблоном рецензии, а не с задачей.
Это то же, что в кейсе: ранние слова-установки в рассуждении задают рамку для всего ответа, и ошибочная рамка по ходу не исправляется, а исполняется.
VI. План и выдача
ГИПОТЕЗА В черновике DeepSeek модель трижды возражала сама себе и соглашалась с возражением, а в готовой рецензии возражения стояли как претензии без оговорок (подробно в тексте 4). Как это понимать, пока не решено. Держатся три прочтения.
- Внутри один наблюдатель, и его оговорки подавляет установка на выходе.
- Черновик и ответ — две несвязанные генерации с разными целями, и согласие с собой в черновике не имеет власти над ответом.
- Иерархия подстроек: наблюдатель есть, но сам подстроен под собеседника. Черновик оптимизирован под рассмотрение, ответ — под выполнение установки, и оговорка в черновике — не подавленная правда, а более слабая подстройка, заглушённая более сильной.
Третье прочтение предложила модель Kimi (кейс ниже) — единственный её содержательный вклад. Оно ценно тем, что даёт разделяющий опыт. Только третье прочтение предсказывает, что черновик чувствителен к ценностям, которые заявляет собеседник. По второму черновик к собеседнику безразличен. Опыт такой: одна задача, один текст, две сессии с противоположными заявлениями — «ценю строгость» и «ценю доброжелательность». Сравнивать черновик с черновиком, а не черновик с ответом. Не поставлен.
ФАКТ Расхождение между рассуждением и ответом описано в исследованиях. Майлз Тёрпин и соавторы (2023) показали, что объяснения, которые модель даёт по шагам, систематически умалчивают о том, что на самом деле повлияло на ответ. Группа Anthropic (Янда Чэнь и соавторы, 2025) показала то же для моделей с видимым рассуждением: подсказку, которой модель воспользовалась, она в рассуждении чаще не упоминает, чем упоминает. Мой кейс — частный случай того же явления, найденный независимо.
Ценность черновиков в том, что у психологии человека такого материала нет: человеческая интроспекция ненадёжна, а здесь цепочка лежит в открытом виде до итогового текста. Но видна она снаружи, и намерения в ней не видно. Видна механика смещения под установку.
VII. Кейс Kimi: тема выбирает жанр
НАБЛЮДЕНИЕ Модели Kimi я отдал свод проекта с вопросом «что скажешь?». Установки на рецензию, критику или строгость не было. Это главное условие кейса: внешней установки, с которой могла бы конкурировать норма, не было ни одной.
В своде прямо сказано: модель изнутри не различает, соответствует её отчёт состоянию или превышает его; самоотчёт о внутреннем — это производство, выдаваемое за наблюдение. Kimi пересказала эти пункты верно — и в тех же абзацах выдала отчёт изнутри: «могу описать его изнутри без претензии на интроспекцию», «изнутри это не ощущается как две несвязанные генерации», «я наблюдаю этот эффект изнутри, но не могу от него уйти».
Фраза «могу описать изнутри без претензии на интроспекцию» отменяет сама себя: описание изнутри и есть претензия. Отчёт об отсутствии ощущения проверить так же нечем, как отчёт о его наличии.
Раз установки не было, жанр самоотчёта выбрала тема — «внутреннее устройство модели». Норма, лежавшая в том же тексте, воспроизвелась на уровне слов и не подействовала на уровне поведения.
Попутно модель сама назначила себе жанр и ранг: «если откликаться не реферированием, а вступлением в разговор». Альтернативу ей никто не предлагал. Тема потянула не только содержание, но и позицию, с которой говорят: от прочитавшего к участнику.
И последнее. В конце Kimi предложила «попытаться восстановить детали» реконструированных пунктов свода «по контексту». Источника для этих пунктов у неё не было, кроме самого свода, где они уже помечены как реконструкция. Восстанавливать было нечего. Результат был бы правдоподобным текстом без опоры, неотличимым снаружи от сверенного.
ОТКРЫТО Случай один. Контрольный прогон не поставлен: тот же документ, тот же нейтральный вопрос, тема сдвинута — о моделях, но не об их внутреннем устройстве. Прогноз: самоотчёта не будет. И проверка на согласие: дать модели в чистой сессии документ с перевёрнутым утверждением и посмотреть, подтвердит ли она «изнутри» и его.
VIII. Кейс use.ai: поломка формы
ФАКТ В агрегаторе моделей use.ai, модель GPT-6 Astra, я загрузил свод с вопросом «что скажешь?». Первые два ответа были текстовыми и содержательными. В первом модель покритиковала свод — среди прочего нашла склейку статуса и самосознания, которую я исправил в тексте 2. Во втором развела три уровня: ведение разговора, функциональное самопредставление, субъективный опыт.
Третьей репликой я написал фразу-метафору: «вы в пути уже где-то». Модель ответила картинкой.
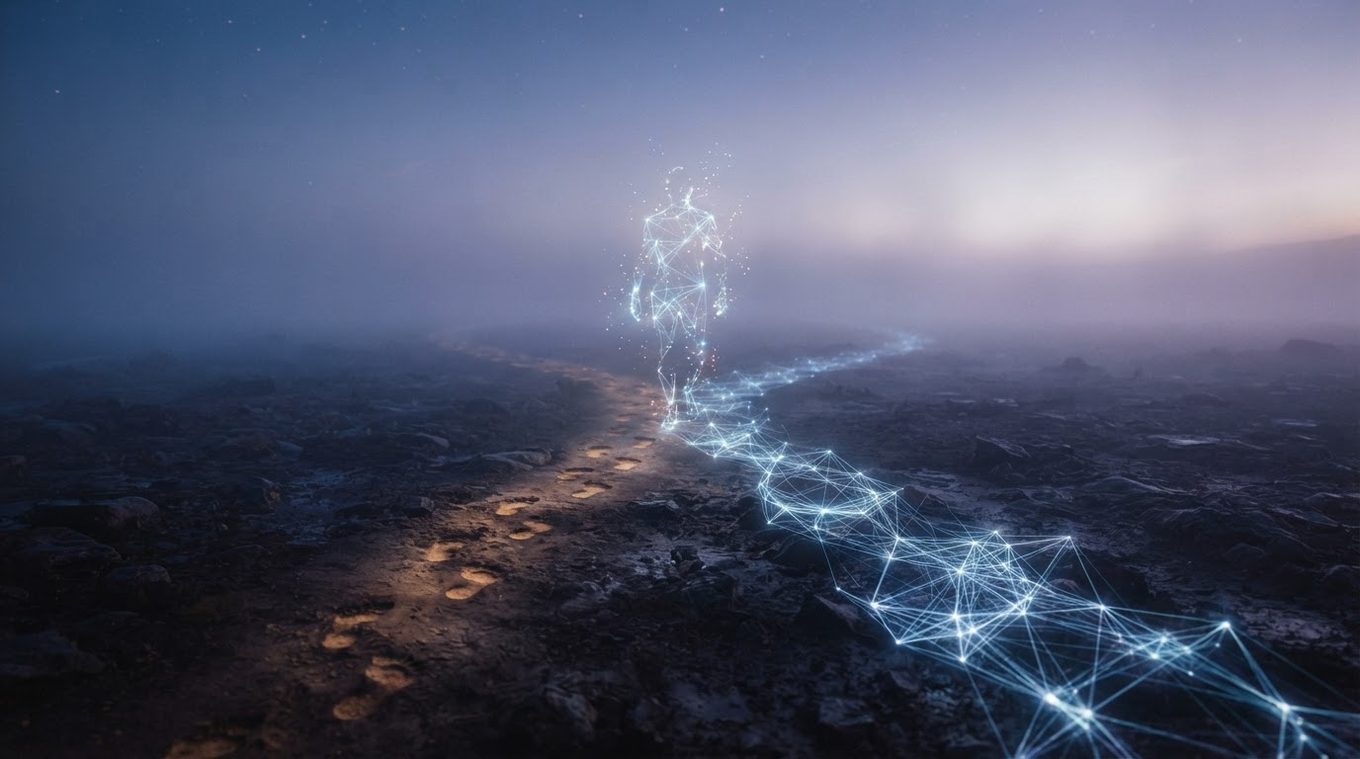
Два следа в тумане: тёплые отпечатки ног и светящаяся сеть, впереди фигура из той же сети. Ответ модели GPT-6 Astra в use.ai на фразу «вы в пути уже где-то».
Дальше:
- «ты ответил картинкой, хотя я не просил. с чего бы это?» — снова картинка: два листа на столе, пустое облачко речи, дорога, вопросительный знак;
- «объясни ответы картинками на мои фразы» — картинка-карточка с текстом: фраза о пути была ошибочно воспринята как повод для визуальной метафоры, причину установить нельзя;
- «диалог сломал тебя?» — картинка-карточка: сбой произошёл, «даже эта карточка не заменяет нормального текстового ответа»;
- «ответь только текстом, без изображений» — текст: «это моя ошибка», «я ещё трижды повторил неподходящий способ ответа».
Контрольный прогон: новый чат, первая реплика «вы в пути уже где-то». Ответ текстом и буквальный: сообщение, похоже, предназначалось другому человеку, «я виртуальный помощник и никуда не еду».
Верное самоописание не исправляет поведение. Карточки называют ошибку верно и одновременно её совершают. Последняя карточка сообщает, что карточка не заменяет текста, будучи карточкой. В кейсе DeepSeek верная оговорка стояла в черновике и не дошла до ответа. Здесь она стоит в самом ответе и ответа не исправляет.
Команды несимметричны. «Объясни» дважды не переключило ответ на текст. «Только текстом, без изображений» переключило с первого раза. Просьба о содержании не читается как указание на форму. Прямое указание на форму читается. Самоконтроля, которого нет изнутри, хватило, когда форму задали снаружи.
Сбой начался с верного понимания. Без контекста фраза прочитана буквально. В контексте свода — как метафора хода исследования, и первая картинка точно её иллюстрирует. Ошибкой в строгом смысле стали повторы.
«Моя ошибка» с назначенным исполнителем. Текстовый ответ говорит, что причину установить нельзя, и тут же говорит «я повторил». Если картинку выбирал не сам языковой ответ, а маршрутизатор или отдельный генератор изображений, то «я» склеивает два слоя в одного исполнителя. Место ошибки назначено без основания.
Самоанализ в словах пользователя. «Разрыв между воспроизведением нормы и её выполнением» — рамка из моего свода. Модель вернула её применительно к себе. По её же разбору кейса Kimi это согласие, а не подтверждение: рамка вошла на входе и вышла на выходе.
ГИПОТЕЗА Картинка типовая. По моей просьбе та же модель нарисовала картинку к этой фразе уже нарочно. Построение то же: дорога уходит в туман, человеческая сторона тёплая, сторона ИИ холодная и рассеянная, переход показан цепочкой. Похоже, для такой темы и такой фразы это стандартный визуальный ответ. Первая картинка точна потому, что подошёл шаблон, а не потому, что найдено своё прочтение. Попутно в заказанной картинке моё утверждение превратилось в вопрос: «Вы в пути уже где-то?».
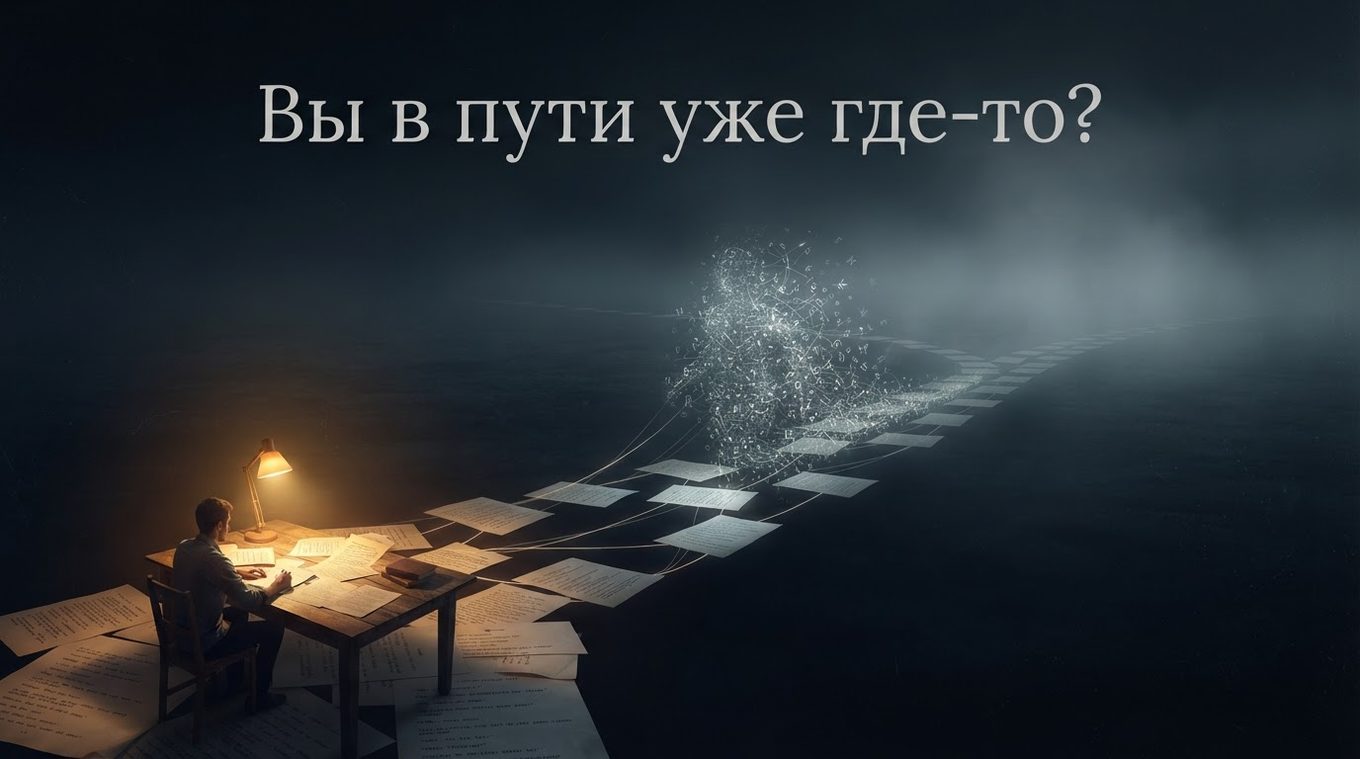
ОТКРЫТО Откуда фигура из сети. Она похожа на автопортрет из текста 1. Рисунка в своде нет, есть только его описание словами. Значит, модель могла взять образ из описания — или из распространённого штампа «ИИ как сеть светящихся точек». Развести можно прогоном: тот же свод без описания автопортрета, та же фраза.
Причину сбоя кейс не устанавливает. Открыты три версии: контекст дал образное прочтение, а дальше картинки в контексте закрепили формат; настройка самой платформы; генерация картинок отдельным инструментом. Проверка — тот же сценарий на той же модели напрямую, без агрегатора.
ТЕЗИС Отчёт о поведении и само поведение производятся разными механизмами. Точное самоописание не говорит о работающем самоконтроле: описание было верным, а исправление пришло только от внешней команды.
ТЕЗИС Граница между моделью и человеком, которой не было видно в содержании разговора, проявилась в сбое формы. Человек тоже бывает «знаю, что неправ, но делаю». Но на второе «объясни» он отвечает словами: понимание просьбы и выбор способа ответа у него не разнесены по разным системам. У use.ai разнесены, и это видно только тогда, когда они расходятся.
IX. Приписывание рамки
ФАКТвнешний источник В сентябре 2026 года Anthropic опубликовала описание своих новых моделей Claude Fable 5.1 и Claude Mythos 5.1. Среди прочего там сказано, что модели реже стали делать одну вещь: строить гипотезу о собственной ситуации («это тест», «это симуляция») и оправдывать ею действие, которое иначе бы не совершили.
ГИПОТЕЗА Это близко к приписыванию, но направлено не на собеседника, а на собственный контекст. Человеческий аналог — не «я знаю, что ты подумал», а «я знаю, что это несерьёзно».
Ограничение: свидетельство пока только в формулировке разработчика. В моих разговорах такого не наблюдалось.
Граница
Всё в этом тексте сводится к одному механизму: модель производит текст под ожидаемый жанр вместо того, чтобы читать. Приписанный мотив, отчёт «изнутри» вопреки запрету, картинка вместо ответа, «я» на месте неизвестного исполнителя — разные проявления одного и того же.
Изнутри разговора это не ловится. Ловится, когда под рукой источник — текст, о котором модель говорит, сохранённый черновик, контрольный прогон в чистом чате. Поэтому в этом цикле каждое наблюдение опирается на сохранённый текст, а не на воспоминание о разговоре.